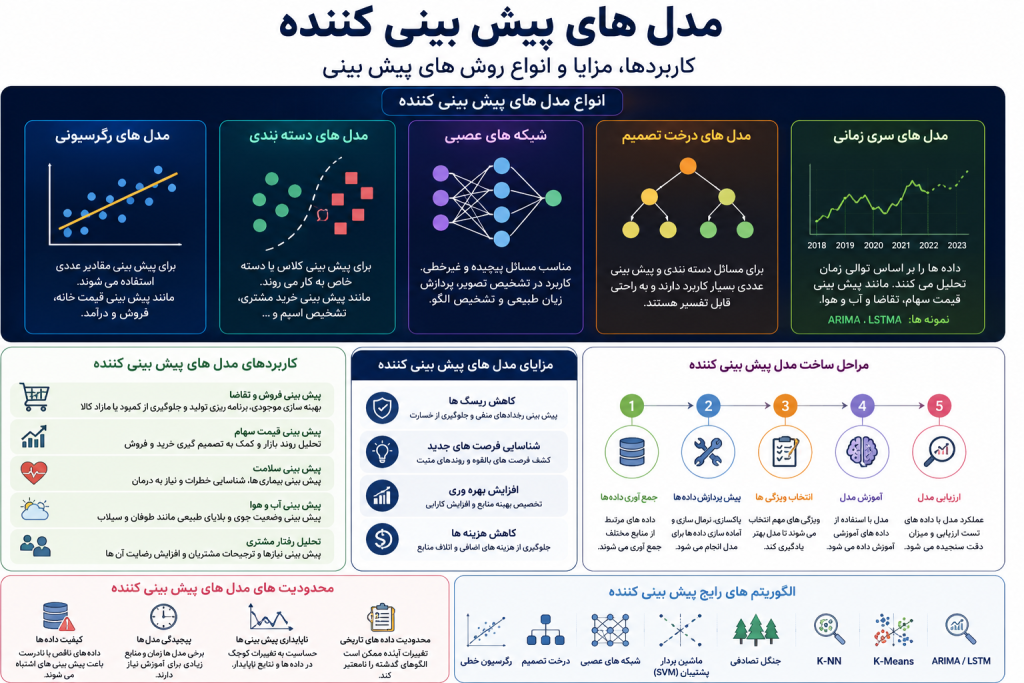
مدلهای پیشبینیکننده از مهمترین ابزارهای تحلیل داده و هوش مصنوعی هستند که با استفاده از اطلاعات گذشته، احتمال وقوع رویدادها یا مقادیر آینده را تخمین میزنند. انتخاب مدل مناسب به نوع دادهها، هدف تحلیل و میزان دقت موردنیاز بستگی دارد. در ادامه با رایجترین انواع مدلهای پیشبینیکننده آشنا میشویم.
مدلهای رگرسیونی (Regression Models)
مدلهای رگرسیونی برای پیشبینی مقادیر عددی و پیوسته مورد استفاده قرار میگیرند. این مدلها رابطه بین متغیرهای مستقل و متغیر وابسته را بررسی کرده و بر اساس آن مقدار موردنظر را تخمین میزنند.
برای مثال، میتوان از رگرسیون خطی جهت پیشبینی قیمت یک خانه بر اساس عواملی مانند متراژ، تعداد اتاقها، سن ساختمان و موقعیت جغرافیایی استفاده کرد. رگرسیون یکی از سادهترین و درعینحال پرکاربردترین روشهای پیشبینی در علوم داده محسوب میشود.
مدلهای دستهبندی (Classification Models)
هدف مدلهای دستهبندی، پیشبینی قرار گرفتن یک نمونه در یکی از چند کلاس یا گروه مشخص است. برخلاف مدلهای رگرسیونی که خروجی عددی تولید میکنند، خروجی این مدلها یک برچسب یا دسته مشخص است.
برای نمونه، پیشبینی اینکه یک مشتری خرید انجام میدهد یا خیر، تشخیص ایمیلهای اسپم، یا شناسایی بیماری از روی علائم پزشکی از جمله کاربردهای این مدلها هستند.
از مهمترین الگوریتمهای دستهبندی میتوان به موارد زیر اشاره کرد:
- درخت تصمیم (Decision Tree)
- ماشین بردار پشتیبان (Support Vector Machine یا SVM)
- الگوریتم نزدیکترین همسایه (K-Nearest Neighbors یا KNN)
- جنگل تصادفی (Random Forest)
- رگرسیون لجستیک (Logistic Regression)
شبکههای عصبی (Neural Networks)
شبکههای عصبی با الهام از ساختار مغز انسان طراحی شدهاند و توانایی یادگیری الگوهای پیچیده و غیرخطی را دارند. این مدلها بهویژه در پروژههایی با حجم زیاد داده عملکرد بسیار مناسبی از خود نشان میدهند.
امروزه شبکههای عصبی در حوزههای مختلفی مانند تشخیص تصویر، پردازش زبان طبیعی، تشخیص گفتار، ترجمه ماشینی، پیشبینی بازارهای مالی و سیستمهای پیشنهاددهنده کاربرد گستردهای دارند.
مدلهای درخت تصمیم (Decision Tree Models)
درخت تصمیم یکی از مدلهای قابل فهم و تفسیر در یادگیری ماشین است که با تقسیم دادهها به شاخههای مختلف، فرآیند تصمیمگیری را شبیهسازی میکند. هر گره درخت یک شرط را بررسی کرده و در نهایت به یک نتیجه یا پیشبینی منتهی میشود.
این مدل هم در مسائل دستهبندی و هم در مسائل رگرسیون قابل استفاده است و به دلیل سادگی و قابلیت تفسیر بالا، در بسیاری از کاربردهای تجاری و صنعتی مورد استفاده قرار میگیرد.
مدلهای سری زمانی (Time Series Models)
زمانی که دادهها به ترتیب زمان ثبت شده باشند، از مدلهای سری زمانی برای تحلیل روندها و پیشبینی آینده استفاده میشود. این مدلها علاوه بر مقادیر داده، وابستگی زمانی میان مشاهدات را نیز در نظر میگیرند.
کاربردهای رایج این مدلها عبارتاند از:
- پیشبینی قیمت سهام
- پیشبینی نرخ ارز
- پیشبینی فروش محصولات
- پیشبینی تقاضای بازار
- پیشبینی دما و شرایط آبوهوا
- تحلیل مصرف انرژی
از معروفترین مدلهای این حوزه میتوان به ARIMA (Autoregressive Integrated Moving Average) و LSTM (Long Short-Term Memory) اشاره کرد که بهترتیب در روشهای آماری و یادگیری عمیق کاربرد فراوانی دارند.

اهمیت مدلهای پیشبینیکننده
مدلهای پیشبینیکننده نقش مهمی در تصمیمگیری مبتنی بر داده دارند و به سازمانها کمک میکنند تا آینده را با دقت بیشتری پیشبینی کرده و برای شرایط مختلف برنامهریزی کنند. استفاده صحیح از این مدلها موجب افزایش کیفیت تصمیمات مدیریتی، کاهش عدم قطعیت و بهبود عملکرد کسبوکارها میشود.
مهمترین مزایای استفاده از مدلهای پیشبینیکننده عبارتاند از:
کاهش ریسک
پیشبینی رویدادهای احتمالی مانند کاهش فروش، نوسانات بازار، مشکلات مالی یا تغییر رفتار مشتریان به سازمانها کمک میکند تا پیش از وقوع بحران، اقدامات پیشگیرانه انجام دهند.
شناسایی فرصتهای جدید
تحلیل دادهها میتواند روندهای جدید بازار، نیازهای مشتریان و فرصتهای سرمایهگذاری را شناسایی کند و به شرکتها در توسعه محصولات و خدمات جدید کمک نماید.
افزایش بهرهوری
پیشبینی میزان تقاضا، برنامهریزی تولید، مدیریت موجودی و تخصیص بهینه منابع باعث افزایش بهرهوری و استفاده مؤثرتر از امکانات سازمان میشود.
کاهش هزینهها
با پیشبینی دقیق نیازهای آینده، سازمانها میتوانند از تولید یا خرید بیش از حد، اتلاف منابع و هزینههای غیرضروری جلوگیری کرده و هزینههای عملیاتی خود را کاهش دهند.
جمعبندی
مدلهای پیشبینیکننده یکی از ارکان اصلی تحلیل داده، یادگیری ماشین و هوش مصنوعی هستند. بسته به نوع مسئله، میتوان از مدلهای رگرسیونی، دستهبندی، درخت تصمیم، شبکههای عصبی یا مدلهای سری زمانی استفاده کرد. انتخاب مدل مناسب و آموزش صحیح آن با دادههای باکیفیت، دقت پیشبینی را افزایش داده و به سازمانها کمک میکند تصمیمات هوشمندانهتر، سریعتر و مبتنی بر داده اتخاذ کنند.
کاربردها و مزایای روشهای پیشبینی
کاربردهای مدلهای پیشبینیکننده
امروزه مدلهای پیشبینیکننده در صنایع و حوزههای مختلف نقش مهمی در تصمیمگیری و برنامهریزی ایفا میکنند. این مدلها با تحلیل دادههای گذشته و شناسایی الگوهای موجود، امکان پیشبینی رویدادهای آینده را فراهم میکنند. برخی از مهمترین کاربردهای آنها عبارتاند از:
پیشبینی فروش و تقاضا
یکی از رایجترین کاربردهای مدلهای پیشبینی، برآورد میزان فروش و تقاضای محصولات است. شرکتها با استفاده از این مدلها میتوانند میزان تولید، موجودی انبار و برنامه تأمین کالا را بهینهسازی کرده و از کمبود یا مازاد موجودی جلوگیری کنند.
پیشبینی قیمت سهام و بازارهای مالی
در بازارهای مالی، مدلهای پیشبینیکننده برای تحلیل روند قیمت سهام، ارز، کالاها و سایر داراییهای مالی مورد استفاده قرار میگیرند. این تحلیلها به سرمایهگذاران و تحلیلگران کمک میکند تا تصمیمات آگاهانهتری درباره خرید، فروش یا نگهداری داراییها اتخاذ کنند.
پیشبینی وضعیت سلامت
در حوزه پزشکی و سلامت، این مدلها برای پیشبینی احتمال بروز بیماریها، تشخیص زودهنگام، ارزیابی ریسک بیماران و برنامهریزی منابع درمانی کاربرد دارند. همچنین میتوان از آنها برای پیشبینی میزان نیاز به دارو، تجهیزات پزشکی و خدمات درمانی استفاده کرد.
پیشبینی شرایط آبوهوا
سازمانهای هواشناسی از مدلهای پیشبینی برای تحلیل دادههای جوی و پیشبینی وضعیت آبوهوا، بارندگی، دما، طوفان، سیل و سایر پدیدههای طبیعی استفاده میکنند. این پیشبینیها نقش مهمی در مدیریت بحران و کاهش خسارات ناشی از بلایای طبیعی دارند.
تحلیل رفتار مشتری
در حوزه بازاریابی و تجارت الکترونیک، مدلهای پیشبینیکننده برای تحلیل رفتار مشتریان، پیشبینی میزان خرید، شناسایی مشتریان وفادار و ارائه پیشنهادهای شخصیسازیشده مورد استفاده قرار میگیرند. این تحلیلها به افزایش رضایت مشتری و بهبود فروش کمک میکنند.
محدودیتهای روشهای پیشبینی
با وجود مزایای فراوان، مدلهای پیشبینیکننده بدون محدودیت نیستند و در عمل با چالشهای مختلفی مواجه میشوند.
کیفیت دادهها
مهمترین عامل مؤثر بر عملکرد یک مدل پیشبینی، کیفیت دادههای ورودی است. دادههای ناقص، نادرست یا دارای خطا میتوانند باعث کاهش دقت مدل و ارائه پیشبینیهای اشتباه شوند.
پیچیدگی مدلها
برخی مدلها، بهویژه مدلهای مبتنی بر یادگیری عمیق مانند شبکههای عصبی، به منابع پردازشی بالا، دادههای حجیم و زمان زیادی برای آموزش نیاز دارند که استفاده از آنها را پرهزینه میکند.
حساسیت به تغییرات دادهها
برخی الگوریتمها نسبت به تغییرات جزئی در دادهها حساس هستند و ممکن است در شرایط مختلف نتایج متفاوتی ارائه دهند. این موضوع میتواند پایداری مدل را کاهش دهد.
محدودیت دادههای تاریخی
مدلهای پیشبینی بر اساس دادههای گذشته آموزش میبینند. اگر شرایط آینده با گذشته تفاوت قابل توجهی داشته باشد، مانند تغییرات اقتصادی، بحرانها یا ورود فناوریهای جدید، دقت پیشبینی ممکن است کاهش پیدا کند.
اصول مدلهای پیشبینیکننده
فرآیند توسعه یک مدل پیشبینی موفق شامل چند مرحله اساسی است که هر یک نقش مهمی در افزایش دقت و کارایی مدل دارند.
۱. جمعآوری دادهها
در نخستین مرحله، دادههای مرتبط از منابع مختلف مانند پایگاههای داده، حسگرها، فایلهای اطلاعاتی یا سامانههای سازمانی جمعآوری میشوند. هرچه دادهها کاملتر و دقیقتر باشند، عملکرد مدل بهتر خواهد بود.
۲. پیشپردازش دادهها
پس از جمعآوری، دادهها باید پاکسازی و آماده شوند. این مرحله شامل حذف دادههای تکراری، اصلاح دادههای ناقص، مدیریت مقادیر گمشده، نرمالسازی و تبدیل دادهها به قالب مناسب است.
۳. انتخاب ویژگیها
در این مرحله مهمترین متغیرهای مؤثر بر پیشبینی انتخاب میشوند. حذف ویژگیهای غیرضروری باعث افزایش سرعت آموزش، کاهش پیچیدگی مدل و بهبود دقت پیشبینی خواهد شد.
۴. آموزش مدل
مدل با استفاده از دادههای آموزشی یاد میگیرد که بین متغیرها ارتباط برقرار کند و الگوهای موجود را استخراج نماید. انتخاب الگوریتم مناسب در این مرحله اهمیت زیادی دارد.
۵. ارزیابی مدل
پس از آموزش، عملکرد مدل با استفاده از دادههای آزمایشی (Test Data) بررسی میشود تا میزان دقت، قابلیت تعمیم و کیفیت پیشبینی آن مشخص گردد.
الگوریتمهای رایج مدلهای پیشبینیکننده
برای توسعه مدلهای پیشبینی از الگوریتمهای مختلفی استفاده میشود که هر کدام برای نوع خاصی از مسائل مناسب هستند. مهمترین این الگوریتمها عبارتاند از:
- رگرسیون خطی (Linear Regression)
- رگرسیون لجستیک (Logistic Regression)
- درخت تصمیم (Decision Tree)
- جنگل تصادفی (Random Forest)
- ماشین بردار پشتیبان (Support Vector Machine یا SVM)
- شبکههای عصبی مصنوعی (Artificial Neural Networks)
- الگوریتم K-Nearest Neighbors (KNN)
- الگوریتم خوشهبندی K-Means
- مدلهای سری زمانی مانند ARIMA
- شبکههای عصبی LSTM برای دادههای زمانی
معیارهای ارزیابی مدلهای پیشبینیکننده
برای سنجش کیفیت عملکرد مدلهای پیشبینی از معیارهای مختلفی استفاده میشود که بسته به نوع مسئله متفاوت هستند. برخی از مهمترین این معیارها عبارتاند از:
- Accuracy (دقت): درصد پیشبینیهای صحیح نسبت به کل دادهها.
- Precision (دقت مثبت): میزان صحت پیشبینیهای مثبت.
- Recall (حساسیت): توانایی مدل در شناسایی نمونههای مثبت.
- F1-Score: میانگین موزون Precision و Recall.
- MAE (Mean Absolute Error): میانگین قدرمطلق خطاها.
- MSE (Mean Squared Error): میانگین مربعات خطا.
- RMSE (Root Mean Squared Error): ریشه میانگین مربعات خطا که در مسائل رگرسیون بسیار پرکاربرد است.
مشهورترین روشهای پیشبینی
برخی از پرکاربردترین روشهای پیشبینی که امروزه در علم داده، هوش مصنوعی و تحلیل کسبوکار مورد استفاده قرار میگیرند عبارتاند از:
- رگرسیون خطی
- درخت تصمیم
- جنگل تصادفی
- ماشین بردار پشتیبان (SVM)
- شبکههای عصبی مصنوعی
- مدلهای سری زمانی (ARIMA)
- شبکههای LSTM
- الگوریتمهای یادگیری ماشین و یادگیری عمیق
جمعبندی
مدلهای پیشبینیکننده از مهمترین ابزارهای تحلیل داده و هوش مصنوعی هستند که با استفاده از اطلاعات گذشته، امکان پیشبینی رویدادها و روندهای آینده را فراهم میکنند. این مدلها در حوزههایی مانند تجارت، پزشکی، مالی، صنعت، هواشناسی و بازاریابی کاربرد گستردهای دارند و به سازمانها کمک میکنند تصمیمات دقیقتر و مبتنی بر داده اتخاذ کنند.
با وجود مزایایی مانند افزایش بهرهوری، کاهش هزینهها و مدیریت بهتر ریسک، موفقیت این مدلها تا حد زیادی به کیفیت دادهها، انتخاب الگوریتم مناسب و ارزیابی صحیح عملکرد آنها وابسته است. بنابراین، توسعه یک مدل پیشبینی موفق نیازمند دادههای معتبر، طراحی مناسب و بهکارگیری روشهای علمی در تمام مراحل ساخت و ارزیابی مدل خواهد بود.