بررسی علمی پارادوکس «Less is More» در یادگیری ماشین، تحلیل فوتبال و بازارهای شرطبندی ورزشی
یکی از رایجترین باورها در عصر کلانداده (Big Data) این است که «هرچه داده بیشتر باشد، مدل بهتر خواهد بود». این تصور، که تا حدی از موفقیت شرکتهایی مانند گوگل، متا و آمازون الهام گرفته، باعث شده بسیاری از تحلیلگران ورزشی و پژوهشگران هوش مصنوعی تلاش کنند تا بیشترین حجم ممکن از دادههای مسابقات، بازیکنان و بازارهای شرطبندی را جمعآوری کنند.
با این حال، تحقیقات چند دهه اخیر در آمار، اقتصادسنجی، نظریه یادگیری آماری و یادگیری ماشین نشان دادهاند که این گزاره همیشه صحیح نیست. در بسیاری از مسائل واقعی، بهویژه در پیشبینی مسابقات فوتبال، افزایش حجم داده بدون توجه به کیفیت، ارتباط، همگنی زمانی و ساختار داده میتواند نه تنها سودمند نباشد، بلکه عملکرد مدل را نیز کاهش دهد.
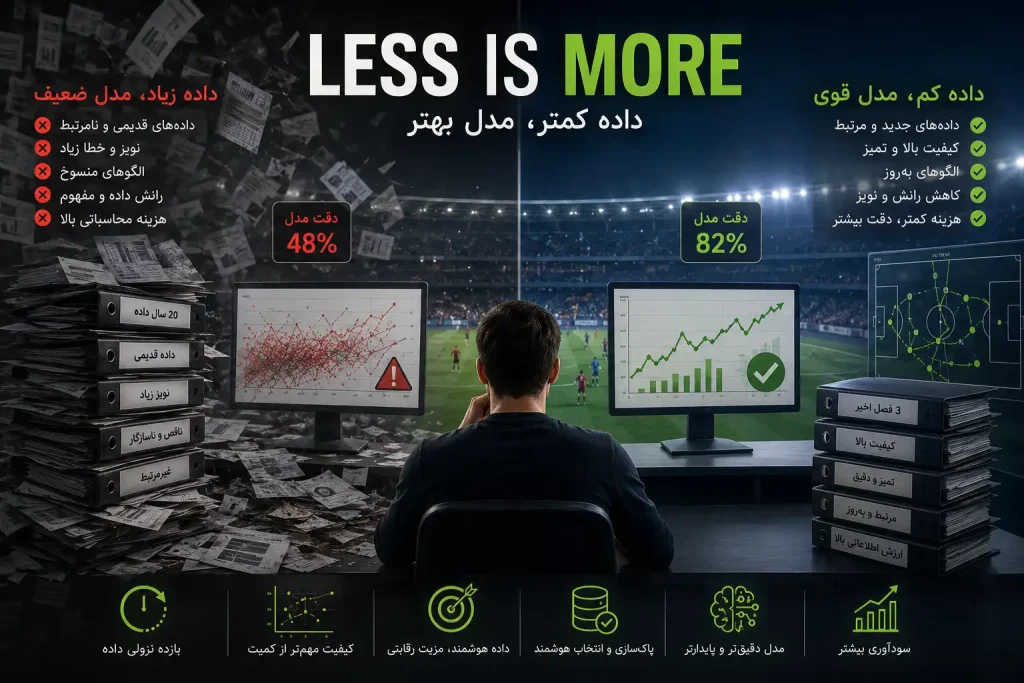
این پدیده که گاهی با عنوان Less is More شناخته میشود، بیان میکند که داده کمتر اما مرتبطتر، تمیزتر و جدیدتر ممکن است نسبت به داده بسیار زیاد اما ناهمگون، قدیمی یا پرنویز، مدلهای دقیقتر و سودآورتری ایجاد کند.
۱. پارادوکس «داده بیشتر»
در نگاه اول، افزایش داده باید باعث کاهش خطای آماری شود.
زیرا:
نمونه بزرگتر
واریانس کمتر
تخمین پایدارتر
خواهد شد.
اما این نتیجه تنها زمانی برقرار است که دادهها:
مستقل باشند.
همتوزیع باشند (IID).
دارای کیفیت مناسب باشند.
از همان فرآیند تولید داده آمده باشند.
در فوتبال، این فرضها معمولاً برقرار نیستند.
۲. چرا داده بیشتر همیشه بهتر نیست؟
هر مشاهده جدید الزاماً اطلاعات جدید اضافه نمیکند.
ممکن است تنها:
نویز بیشتری وارد کند.
روابط قدیمی را حفظ کند.
الگوهای منسوخ را تقویت کند.
مدل را از شرایط فعلی دور کند.
بنابراین ارزش اطلاعاتی هر داده، مهمتر از تعداد آن است.
۳. دیدگاه نظریه اطلاعات
بر اساس نظریه اطلاعات Claude Shannon، آنچه اهمیت دارد اطلاعات جدید (Information Gain) است، نه صرفاً حجم داده.
اگر هزار مسابقه جدید همان الگوهای قبلی را تکرار کنند، اطلاعات بسیار کمی به مدل اضافه میشود.
اما ده مسابقه که یک تغییر تاکتیکی یا قانونی مهم را منعکس کنند، ممکن است ارزش اطلاعاتی بسیار بیشتری داشته باشند.
۴. فوتبال؛ یک سیستم غیرایستا
برخلاف بسیاری از مسائل فیزیکی، فوتبال یک سیستم پویا است.
موارد زیر دائماً تغییر میکنند:
سبک بازی تیمها
مربیان
کیفیت بازیکنان
قوانین مسابقات
فناوری VAR
فشردگی تقویم
رفتار بازار شرطبندی
بنابراین دادههای بسیار قدیمی ممکن است دیگر نماینده واقعیت امروز نباشند.
۵. Concept Drift
یکی از مهمترین دلایل شکست مدلهای مبتنی بر دادههای بسیار زیاد، Concept Drift است.
Concept Drift
یعنی:
رابطه میان ویژگیها و نتیجه مسابقه در طول زمان تغییر کرده است.
در این شرایط، اضافه کردن دادههای قدیمی ممکن است مدل را گمراه کند.
۶. Data Drift
گاهی حتی توزیع دادهها نیز تغییر میکند.
مثلاً:
میانگین xG لیگ افزایش یافته است.
سرعت بازی بیشتر شده است.
تعداد تعویضها تغییر کرده است.
اگر مدل هنوز از دادههای ده سال قبل استفاده کند، بخشی از آموزش آن به توزیعی تعلق دارد که دیگر وجود ندارد.
۷. مثال عملی
فرض کنید قصد پیشبینی لیگ برتر انگلیس فصل جاری را دارید.
دو گزینه دارید:
الف)
تمام دادههای ۲۰ سال گذشته.
ب)
سه فصل اخیر با کیفیت بالا.
در بسیاری از پژوهشها، گزینه دوم عملکرد بهتری دارد؛ زیرا بهتر با شرایط کنونی همخوانی دارد.
۸. نویز تجمعی
با افزایش حجم داده، همیشه اطلاعات افزایش نمییابد؛
گاهی تنها نویز جمع میشود.
نمونههایی از نویز:
اشتباهات ثبت داده
تغییر کیفیت اپراتورها
تغییر استانداردهای آماری
مسابقات غیرعادی
شرایط آبوهوایی نادر
هرچه داده قدیمیتر باشد، احتمال ناسازگاری آن نیز بیشتر است.
۹. قانون بازده نزولی داده
مشابه اقتصاد، داده نیز از قانون بازده نزولی (Diminishing Returns) پیروی میکند.
دادههای اولیه معمولاً بیشترین بهبود را ایجاد میکنند.
اما پس از یک نقطه، هر داده جدید بهبود بسیار اندکی ایجاد میکند و حتی ممکن است هزینه محاسباتی و ریسک بیشبرازش را افزایش دهد.
۱۰. کیفیت در برابر کمیت
فرض کنید دو مجموعه داده داریم:
مجموعه اول:
۵۰ هزار مسابقه
نویز بالا
داده ناقص
تغییر قوانین
برچسبهای ناسازگار
مجموعه دوم:
۸ هزار مسابقه
کیفیت بسیار بالا
ویژگیهای دقیق
برچسبهای معتبر
همگنی زمانی
در بسیاری از کاربردهای واقعی، مجموعه دوم نتایج بهتری ایجاد میکند.
[7/27/2026 8:43 PM] Alfredo: ۱۱. Feature Engineering
بهتر از داده بیشتر
مطالعات متعدد نشان دادهاند که:
بهبود ویژگیها (Feature Engineering)
اغلب تأثیر بیشتری از افزایش حجم داده دارد.
یک ویژگی جدید با اطلاعات بالا ممکن است از افزودن هزاران مسابقه قدیمی ارزشمندتر باشد.
۱۲. اثر بر بیشبرازش
ممکن است تصور شود داده بیشتر همیشه خطر Overfitting را کاهش میدهد.
این تنها زمانی درست است که دادهها از همان توزیع باشند.
اگر دادههای نامرتبط اضافه شوند، مدل ممکن است روابط اشتباه را نیز یاد بگیرد و در نتیجه تعمیم آن کاهش یابد.
۱۳. هزینه محاسباتی
دادههای بزرگتر به معنای:
حافظه بیشتر
زمان آموزش بیشتر
هزینه پردازش بیشتر
مصرف انرژی بیشتر
است.
اگر بهبود دقت ناچیز باشد، این هزینهها از نظر اقتصادی توجیهپذیر نیستند.
۱۴. انتخاب هوشمند داده
یکی از موضوعات مهم در یادگیری ماشین مدرن، Data-Centric AI است.
در این رویکرد، به جای جمعآوری بیپایان داده، تمرکز بر انتخاب دادههای ارزشمندتر است.
این شامل:
حذف دادههای تکراری
حذف دادههای مشکوک
حذف نمونههای قدیمی
حفظ نمونههای اطلاعات دار
میشود.
۱۵. Active Learning
در Active Learning،
مدل خودش تعیین میکند کدام نمونهها بیشترین ارزش آموزشی را دارند. در نتیجه،
به جای میلیونها داده، تنها هزاران نمونه مهم برچسبگذاری میشوند.
۱۶. Core-set Selection
در بسیاری از پروژههای بینایی ماشین و تحلیل ورزشی، از روشهای Core-set Selection استفاده میشود.
هدف:
انتخاب کوچکترین زیرمجموعهای است که بیشترین اطلاعات را حفظ کند.
۱۷. اقتصاد داده
داده رایگان نیست.
جمعآوری داده شامل هزینههای:
خرید داده
ذخیرهسازی
پاکسازی
پردازش
کنترل کیفیت
نگهداری
است.
بنابراین باید میان ارزش اطلاعاتی و هزینه اقتصادی تعادل برقرار شود.
۱۸. بازارهای شرطبندی ورزشی
در شرطبندی حرفهای، دادههای بسیار قدیمی ممکن است حتی زیانآور باشند.
برای مثال:
بازارهای امروزی نسبت به ده سال پیش بسیار کاراتر شدهاند.
استفاده از ضرایب قدیمی ممکن است مدل را نسبت به ساختار فعلی بازار دچار خطا کند.
۱۹. نقش Data Pruning
امروزه بسیاری از تیمهای حرفهای شرط بندی به جای افزودن داده، اقدام به Data Pruning میکنند.
یعنی:
حذف دادههایی که دیگر ارزش اطلاعاتی ندارند.
این کار:
سرعت آموزش را افزایش میدهد.
خطر بیشبرازش را کاهش میدهد.
کیفیت مدل را بهبود میبخشد.
۲۰. یادگیری انتقالی (Transfer Learning)
گاهی به جای جمعآوری دادههای بسیار زیاد، از دانش آموختهشده در مسائل مشابه استفاده میشود.
این روش نشان میدهد که کیفیت دانش اولیه میتواند جایگزین بخشی از حجم داده شود.
۲۱. نقش متخصص انسانی
انتخاب اینکه کدام داده ارزش نگهداری دارد، اغلب نیازمند دانش دامنه است.
برای مثال:
یک تحلیلگر فوتبال میتواند تشخیص دهد که دادههای مربوط به قبل از تغییر قانون پنج تعویض، برای برخی مدلها ارزش کمتری دارند.
۲۲. شواهد پژوهشی
پژوهشهای حوزه یادگیری ماشین نشان دادهاند که:
پاکسازی دادهها
حذف نمونههای نویزی
حذف برچسبهای اشتباه
انتخاب زیرمجموعههای نماینده
اغلب بهبودی هماندازه یا حتی بیشتر از تغییر الگوریتم ایجاد میکنند.
این یافتهها پایه شکلگیری جنبش Data-Centric AI بودهاند.
۲۳. آینده؛ از Big Data به Smart Data
روند آینده از Big Data به سمت Smart Data است.
هدف دیگر «بیشترین داده» نیست، بلکه:
درستترین داده
مرتبطترین داده
جدیدترین داده
تمیزترین داده
اطلاعاتیترین داده
خواهد بود.
در تحلیل فوتبال و بازارهای شرطبندی ورزشی، مزیت رقابتی آینده احتمالاً نه از حجم عظیم داده، بلکه از توانایی انتخاب و مدیریت هوشمند داده حاصل خواهد شد.
این باور که «داده بیشتر همیشه مدل بهتری میسازد» در بسیاری از مسائل واقعی، بهویژه در فوتبال و بازارهای شرطبندی، نادرست است. کیفیت، تازگی، همگنی، ارتباط و ارزش اطلاعاتی دادهها معمولاً بسیار مهمتر از حجم آنها هستند. ورود دادههای قدیمی، پرنویز یا نامرتبط میتواند باعث کاهش دقت، افزایش هزینه محاسباتی و ایجاد سوگیری در مدل شود.
رویکردهای نوین علم داده نشان میدهند که موفقترین سیستمها الزاماً بزرگترین پایگاههای داده را ندارند؛ بلکه پایگاههایی را در اختیار دارند که با دقت انتخاب، پاکسازی و مدیریت شدهاند. در نهایت، در بسیاری از کاربردهای عملی، داده کمتر اما هوشمندانهتر میتواند نسبت به داده بیشتر اما بیکیفیتتر، مدلهای دقیقتر، پایدارتر و از نظر اقتصادی سودآورتری ایجاد کند.
[7/27/2026 8:46 PM] Alfredo: هزینه سرمایه در سندیکاهای شرطبندی
Cost of Capital in Betting Syndicates
در نگاه بسیاری از افراد، سرمایه در شرطبندی صرفاً «پولی برای شرط بستن» است؛ اما در سطح حرفهای، سرمایه یک منبع اقتصادی کمیاب با هزینه مشخص است. همانگونه که شرکتها برای تأمین مالی پروژههای خود با مفاهیمی مانند هزینه سرمایه (Cost of Capital)، نرخ بازده مورد انتظار، ریسک و هزینه فرصت سروکار دارند، سندیکاهای حرفهای شرطبندی نیز ناگزیرند سرمایه خود را بر پایه اصول اقتصاد مالی مدیریت کنند.
یک سندیکای شرطبندی (Betting Syndicate) مجموعهای سازمانیافته از سرمایه، داده، فناوری و نیروی انسانی است که با هدف استخراج بازده تعدیلشده بر حسب ریسک (Risk-Adjusted Return) از ناکاراییهای بازار فعالیت میکند. در چنین ساختاری، پرسش اصلی دیگر این نیست که «آیا یک شرط سودآور است؟» بلکه این است که:
«آیا این شرط بازدهی بالاتری از هزینه سرمایه سندیکا ایجاد میکند؟»
این مقاله به بررسی مفهوم هزینه سرمایه، اجزای آن، نحوه اندازهگیری، ارتباط آن با مدیریت سرمایه، نقدشوندگی، ریسک عملیاتی و ارزش اقتصادی در سندیکاهای شرطبندی میپردازد.
۱. سندیکای شرطبندی چیست؟
سندیکای شرطبندی یک سازمان سرمایهگذاری تخصصی است که معمولاً دارای اجزای زیر است:
سرمایهگذاران (Capital Providers)
تحلیلگران داده
متخصصان مدلسازی آماری
معاملهگران (Traders)
برنامهنویسان و مهندسان هوش مصنوعی
مدیر ریسک
مدیر سرمایه (Portfolio Manager)
از منظر اقتصادی، سندیکا بیش از آنکه شبیه یک قمارباز باشد، به یک صندوق سرمایهگذاری کمی (Quantitative Investment Fund) شباهت دارد.
۲. تعریف هزینه سرمایه
(Cost of Capital)
هزینه سرمایه عبارت است از:
حداقل نرخ بازدهی که سرمایهگذاران برای در اختیار گذاشتن سرمایه خود انتظار دارند.
به بیان دیگر:
اگر سندیکا نتواند بازدهی بالاتر از هزینه سرمایه ایجاد کند، از دید اقتصادی ارزشی خلق نکرده است.
۳. چرا سرمایه رایگان نیست؟
حتی اگر سرمایه متعلق به خود سندیکا باشد، باز هم رایگان نیست.
زیرا سرمایه همیشه دارای:
هزینه فرصت (Opportunity Cost)
ریسک
ارزش زمانی پول
هزینه نقدشوندگی
است.
مثلاً اگر سرمایه بتواند در بازار دیگری سالانه ۱۲٪ بازده کمریسک ایجاد کند، پروژه شرطبندی باید بیش از این مقدار بازده مورد انتظار داشته باشد تا توجیه اقتصادی پیدا کند.
۴. اجزای هزینه سرمایه
هزینه سرمایه در یک سندیکا معمولاً از پنج جزء تشکیل میشود:
الف) هزینه فرصت سرمایه
اگر سرمایه در جای دیگری سرمایهگذاری میشد چه بازدهی ایجاد میکرد؟
ب) صرف ریسک (Risk Premium)
بازار شرطبندی دارای:
ریسک مدل
ریسک نقدشوندگی
ریسک عملیاتی
ریسک قانونی
است.
بنابراین سرمایهگذار بازده بیشتری مطالبه میکند.
ج) هزینه نقدشوندگی
بخشی از سرمایه ممکن است:
در حسابها بلوکه شود.
بین چند بوکمیکر توزیع شود.
امکان برداشت سریع نداشته باشد.
این موضوع هزینه اقتصادی دارد.
د) هزینه فناوری
سندیکای حرفهای باید هزینههای زیر را بپردازد:
سرورها
دادههای زنده
ای پی آی
زیرساخت ابری
سیستمهای مدیریت سفارش
هـ) هزینه سازمان
شامل:
حقوق کارکنان
حسابداری
امور حقوقی
امنیت اطلاعات
انطباق مقررات (Compliance)
۵. ساختار سرمایه در سندیکا
برخلاف شرکتهای بورسی، سندیکاها معمولاً بدهی بانکی اندکی دارند و بیشتر از:
سرمایه مؤسسان
سرمایه شرکا
سرمایه سرمایهگذاران خصوصی
استفاده میکنند.
بنابراین، هزینه سرمایه آنها عمدتاً «هزینه حقوق صاحبان سرمایه» است.
۶. بازده مورد انتظار سرمایهگذاران
سرمایهگذار حرفهای صرفاً به سود اسمی نگاه نمیکند.
او معیارهایی مانند:
نرخ بازده سالانه
حداکثر افت سرمایه (Maximum Drawdown)
نسبت شارپ (Sharpe Ratio)
نسبت سورتینو (Sortino Ratio)
نوسان بازده
را نیز بررسی میکند.
در نتیجه، سندیکا باید بازدهی ارائه دهد که هم از نظر مقدار و هم از نظر کیفیت، جذابتر از گزینههای جایگزین باشد.
۷. رابطه Edge و هزینه سرمایه
داشتن Edge مثبت کافی نیست.
اگر:
Edge = ۲٪
اما هزینه سرمایه:
۳٪
باشد،
در بلندمدت ارزش اقتصادی ایجاد نشده است.
بنابراین شرط لازم برای سرمایهگذاری:
Expected Return > Cost of Capital
است.
۸. هزینه سرمایه و مدیریت سرمایه
مدیر سرمایه سندیکا باید دائماً تصمیم بگیرد:
چه مقدار سرمایه وارد هر بازار شود؟
چه مقدار نقد باقی بماند؟
چه مقدار برای فرصتهای آینده حفظ شود؟
هر واحد سرمایهای که در یک شرط قفل میشود، دیگر در فرصتهای دیگر قابل استفاده نیست.
این همان هزینه فرصت است.
[7/27/2026 8:46 PM] Alfredo: مدلهای مدیریت موجودی سرمایه در بوکمیکرها
Inventory Risk Management in Sports Bookmaking
یکی از مهمترین تفاوتهای یک بوکمیکر حرفهای با یک قمارباز، مدیریت موجودی سرمایه
(Inventory Risk Management)
است. برخلاف تصور عمومی، بزرگترین ریسک بوکمیکرها «اشتباه در پیشبینی مسابقه» نیست، بلکه تمرکز بیش از حد تعهدات مالی (Liability Concentration) روی یک یا چند نتیجه است. اگر حجم شرطهای دریافتی بهطور نامتوازن روی یک نتیجه متمرکز شود، بوکمیکر در معرض ریسک موجودی (Inventory Risk) قرار میگیرد؛ مفهومی که شباهت بسیار زیادی با ریسک موجودی در بازارسازی بورس، بازار ارز و بازار مشتقات دارد.
اقتصاددانان امروز، بوکمیکر را نه صرفاً فروشنده ضریب، بلکه بازارساز (Market Maker) میدانند که باید همزمان سه هدف را دنبال کند:
حداکثرسازی سود مورد انتظار
حداقلسازی ریسک سرمایه
حفظ نقدشوندگی و تداوم فعالیت
این مقاله، ساختار علمی و عملی مدلهای مدیریت موجودی سرمایه در بوکمیکرها را بر پایه ادبیات اقتصاد مالی، ریزساختار بازار و پژوهشهای دانشگاهی بررسی میکند.
۱. مفهوم موجودی (Inventory) در بوکمیکینگ
در صنایع تولیدی، موجودی یعنی کالا.
در بازارهای مالی، موجودی یعنی داراییهای نگهداریشده توسط بازارساز.
اما در بوکمیکینگ:
موجودی، مجموعه تعهدات مالی (Liabilities) ناشی از شرطهای پذیرفتهشده است.
به بیان دیگر، بوکمیکر موجودی «پولی که ممکن است مجبور به پرداخت آن شود» را مدیریت میکند، نه موجودی کالا.
۲. Inventory Risk
چیست؟
ریسک موجودی زمانی ایجاد میشود که:
تعهدات بوکمیکر نسبت به نتایج مختلف متعادل نباشد.
مثال:
۹۰٪ پول روی تیم A
۱۰٪ روی تیم B
اگر تیم A برنده شود:
پرداخت بسیار بزرگی لازم خواهد بود.
این همان Inventory Risk است.
۳. چرا Inventory Risk مهم است؟
زیرا حتی اگر:
مدل قیمتگذاری صحیح باشد،
حاشیه سود (Margin) مناسب باشد،
تمرکز بیش از حد شرطها میتواند باعث:
کاهش شدید نقدینگی
فشار بر سرمایه
ورشکستگی
شود. پژوهشهای مربوط به مدلهای بوکمیکینگ نشان میدهند که شوکهای تصادفی در تقاضای شرطبندی میتوانند موجودی تعهدات را بهسرعت نامتوازن کنند و بوکمیکر ناچار است با تنظیم ضرایب، جریان شرطها را به سمت تعادل هدایت کند.
۴. ساختار ترازنامه بوکمیکر
از دید اقتصاد مالی:
داراییها:
وجه نقد
ذخایر نقد
سرمایه شرکت
بدهیها:
پرداختهای احتمالی
بونوسها
تعهدات باز
بنابراین:
Inventory = Outstanding Betting Liabilities
۵. هدف مدیریت موجودی
هدف، حذف کامل ریسک نیست.
بلکه:
کنترل توزیع ریسک میان نتایج مختلف است.
یعنی:
کاهش واریانس پرداختها
جلوگیری از تمرکز ریسک
حفظ سرمایه
۶. مدل سنتی Balanced Book
قدیمیترین مدل بوکمیکینگ:
Balanced Book
هدف:
تقریباً برابر کردن مسئولیت مالی روی تمام نتایج.
مثلاً:
برد A → پرداخت ۱ میلیون دلار
برد B → پرداخت ۹۸۰ هزار دلار
تساوی → پرداخت ۱٫۰۲ میلیون دلار
در این حالت:
تقریباً نتیجه مسابقه اهمیت خود را از دست میدهد.
۷. مدل Profit Maximization
در دهههای اخیر، بسیاری از بوکمیکرهای بزرگ دیگر صرفاً به دنبال متعادل کردن دفتر شرطها نیستند.
آنها:
مدل احتمال دارند.
ریسک را میپذیرند.
عمداً Exposure ایجاد میکنند.
اگر مدل داخلی احتمال برد تیمی را کمتر از بازار بداند، ممکن است آگاهانه در برابر آن نتیجه، موجودی بیشتری نگه دارد.
۸. Liability Management
هر شرط جدید:
Liability
را تغییر میدهد.
بنابراین سیستم باید دائماً محاسبه کند:
حداکثر پرداخت
Expected Payout
Worst Case Loss
Value at Risk (VaR)
۹. Dynamic Odds Adjustment
مهمترین ابزار مدیریت موجودی:
تغییر ضرایب.
اگر پول زیادی روی یک تیم بیاید:
ضریب آن کاهش مییابد.
همزمان:
ضریب طرف مقابل افزایش پیدا میکند.
هدف:
هدایت سرمایه به سمت نتیجهای که تعهد کمتری دارد.
این فرآیند مشابه تنظیم قیمت توسط بازارسازان مالی برای کنترل موجودی است.
۱۰. Hedging
اگر Exposure بیش از حد شود،
بوکمیکر ممکن است:
در Betting Exchange شرط معکوس ببندد.
با سایر بوکمیکرها ریسک را تقسیم کند.
از بازارهای مشتقه مرتبط استفاده کند.
به این فرآیند:
Risk Hedging
گفته میشود.
۱۱. مدل Mean-Variance
برخی بوکمیکرها مسئله را مانند یک پرتفوی سرمایهگذاری حل میکنند.
هدف:
Maximize Expected Profit
همزمان با:
Minimize Variance
در این مدل:
تعادل میان سود و ریسک برقرار میشود.
۱۲. مدل Value at Risk (VaR)
یکی از رایجترین ابزارها:
[7/27/2026 8:46 PM] Alfredo: VaR
است.
مثلاً:
در سطح اطمینان ۹۹٪
حداکثر زیان روزانه:
۲ میلیون دلار
اگر Exposure از این حد عبور کند:
سیستم:
ضریب را تغییر میدهد.
سقف شرط را کاهش میدهد.
هج انجام میدهد.
۱۳. Conditional Value at Risk (CVaR)
CVaR
از VaR کاملتر است.
زیرا:
میانگین زیانهای فراتر از VaR را اندازه میگیرد.
در سندیکاها و بوکمیکرهای بزرگ:
CVaR
معمولاً معیار اصلی مدیریت ریسک است.
۱۴. Inventory Constraints
هر بوکمیکر دارای محدودیتهایی است:
حداکثر تعهد روی هر مسابقه
حداکثر تعهد روی هر لیگ
حداکثر تعهد روی هر مشتری
حداکثر تعهد روزانه
این محدودیتها بخشی از سیاست مدیریت سرمایه هستند.
۱۵. مدیریت موجودی با هوش مصنوعی
سیستمهای جدید از AI استفاده میکنند.
وظایف:
پیشبینی جریان شرطها
تشخیص مشتریان حرفهای
تخمین Exposure آینده
پیشنهاد تغییر Odds
در نتیجه:
مدیریت موجودی از حالت واکنشی به حالت پیشبینانه تبدیل شده است.
۱۶. نقش نقدشوندگی
هرچه بازار نقدشوندهتر باشد:
هج آسانتر است.
هزینه انتقال ریسک کمتر است.
Inventory Risk
کاهش مییابد.
به همین دلیل، نقدشوندگی یک مزیت رقابتی مهم برای بوکمیکرها محسوب میشود.
۱۷. مدیریت مشتریان حرفهای
بوکمیکرها مشتریان را از نظر اثر بر موجودی طبقهبندی میکنند:
مشتری تفریحی
مشتری نیمهحرفهای
مشتری حرفهای
سندیکای شرطبندی
شرطهای گروه آخر میتوانند موجودی ریسک را بهطور محسوسی تغییر دهند،
بنابراین معمولاً:
محدودیت حجم
بررسی دستی
قیمتگذاری اختصاصی
برای آنها اعمال میشود.
۱۸. مدیریت ریسک شرط های میکس (Accumulators)
در شرطهای چند تایی:
ریسک بهصورت غیرخطی افزایش مییابد.
ممکن است:
صدها هزار شرط
روی یک نتیجه مشترک باشند.
اگر آن نتیجه رخ دهد:
پرداختها بهشدت افزایش مییابد.
مدلسازی این ریسک یکی از پیچیدهترین مسائل بوکمیکینگ مدرن است و پژوهشهای اخیر از فرآیندهای تصادفی برای تحلیل احتمال ورشکستگی سرمایه بوکمیکر در این شرایط استفاده کردهاند.
۱۹. ارتباط Inventory Risk با قیمتگذاری
قیمتگذاری فقط بر اساس احتمال انجام نمیشود.
بلکه تابعی از:
احتمال واقعی
موجودی فعلی
ریسک سرمایه
نقدشوندگی
رفتار مشتری
است.
در نتیجه:
دو بوکمیکر
ممکن است برای یک مسابقه:
احتمال یکسان
اما Odds متفاوتی ارائه دهند.
۲۰. تفاوت بوکمیکر قانونی و فراساحلی (آف شور)
مطالعات نشان دادهاند که بوکمیکرهای فراساحلی یا دارای دسترسی محدود به منابع مالی، به دلیل اتکا به سرمایه داخلی، بیشتر بر متعادل نگه داشتن دفتر شرطها تمرکز میکنند و حاضرند بخشی از سود مورد انتظار را برای کاهش نوسان جریان نقدی قربانی کنند. در مقابل، بوکمیکرهایی که دسترسی به منابع مالی و ابزارهای هج دارند، میتوانند ریسک بیشتری بپذیرند و بیشتر بر حداکثرسازی سود تمرکز کنند.
۲۱. ریسک ورشکستگی (Risk of Ruin)
هدف نهایی مدیریت موجودی:
کاهش احتمال ورشکستگی است.
حتی اگر امید ریاضی سود مثبت باشد،
تمرکز بیش از حد تعهدات
میتواند سرمایه شرکت را از بین ببرد.
به همین دلیل:
مدیر ریسک همیشه بدترین سناریو را نیز محاسبه میکند.
۲۲. آینده مدیریت موجودی
روندهای آینده شامل:
قیمتگذاری بلادرنگ مبتنی بر یادگیری ماشین
بهینهسازی چندهدفه
(Multi-objective Optimization)
هج خودکار میان چندین بازار
مدلهای شبکهای برای تحلیل وابستگی شرطها
استفاده از یادگیری تقویتی (Reinforcement Learning) برای تنظیم همزمان ضرایب و موجودی
خواهد بود.
این تحول، بوکمیکر را بیش از پیش به یک بازارساز الگوریتمی در بازارهای مالی نزدیک میکند.
مدیریت موجودی سرمایه، قلب تپنده عملیات یک بوکمیکر مدرن است. سودآوری پایدار تنها با تعیین ضرایب دقیق حاصل نمیشود، بلکه نیازمند کنترل پیوسته تعهدات مالی، تنظیم پویای ضرایب، هج هوشمند، مدیریت نقدشوندگی و تخصیص بهینه سرمایه است. از این منظر، بوکمیکر نه صرفاً یک پذیرنده شرط، بلکه یک مدیر پرتفوی ریسک است که باید میان سود مورد انتظار، ثبات جریان نقدی و احتمال ورشکستگی تعادل برقرار کند.
به همین دلیل، پیشرفتهترین بوکمیکرهای جهان از همان مفاهیم و ابزارهایی استفاده میکنند که در بازارسازی بورس، معاملات با فرکانس بالا و مدیریت ریسک بانکهای سرمایهگذاری به کار گرفته میشود؛ تفاوت اصلی تنها در ماهیت دارایی پایه است، نه در منطق اقتصادی مدیریت موجودی.