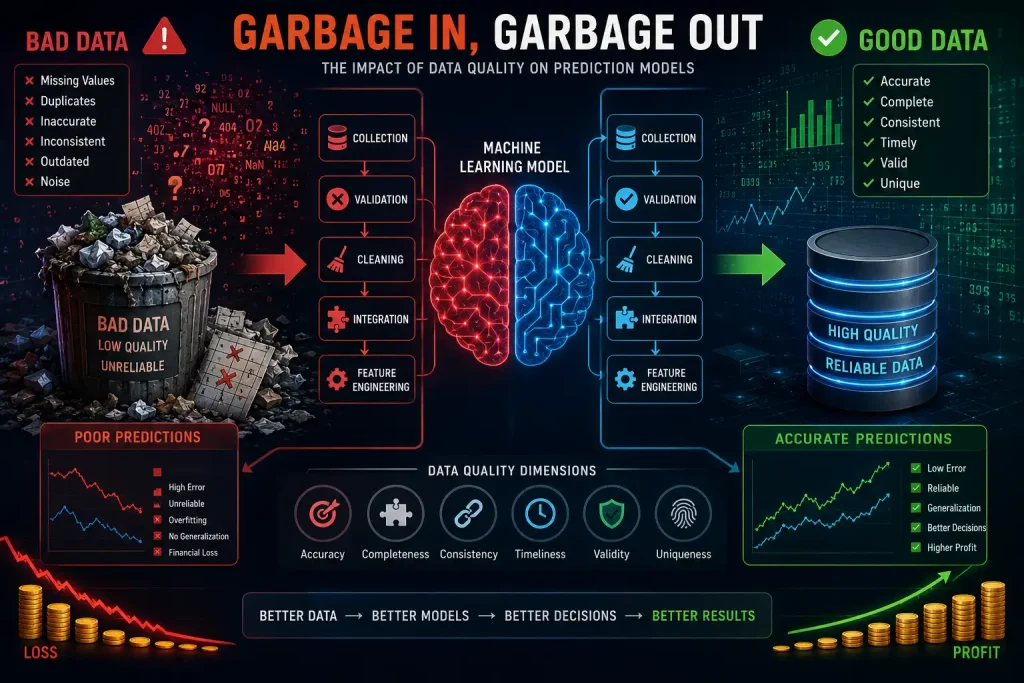
Garbage In, Garbage Out
اقتصاد داده در مدلهای پیشبینی بازارهای شرطبندی
در سالهای اخیر، با رشد یادگیری ماشین، هوش مصنوعی و تحلیل کلانداده، بسیاری تصور میکنند که قدرت مدلهای پیشبینی عمدتاً به الگوریتم وابسته است. اما تجربه عملی بزرگترین صندوقهای سرمایهگذاری کمی، شرکتهای فناوری و سندیکاهای شرطبندی نشان میدهد که این تصور اشتباه است.
واقعیت این است که بیشترین منبع خطا در مدلهای پیشبینی، خود مدل نیست؛ بلکه دادههای ورودی است.
در علوم داده این اصل با عبارت مشهور Garbage In, Garbage Out (GIGO) شناخته میشود:
«اگر دادههای ورودی بیکیفیت باشند، حتی پیشرفتهترین الگوریتمها نیز خروجی بیکیفیت تولید خواهند کرد.»
در بازارهای شرطبندی، اختلاف میان یک مدل سودآور و یک مدل زیانده، اغلب نه در نوع الگوریتم، بلکه در کیفیت، دقت، پوشش، زمانبندی، پاکسازی و مهندسی دادهها نهفته است.
این مقاله به بررسی علمی نقش کیفیت داده در اقتصاد پیشبینی، یادگیری ماشین و مدلهای کمی شرطبندی میپردازد.
۱. اصل Garbage In, Garbage Out چیست؟
این اصل نخستین بار در علوم رایانه مطرح شد.
مفهوم آن بسیار ساده است:
اگر ورودی اشتباه باشد،
خروجی نیز اشتباه خواهد بود.
بدون توجه به اینکه:
الگوریتم چقدر پیچیده است.
سختافزار چقدر قدرتمند است.
مدل چقدر پیشرفته است.
۲. چرا داده مهمتر از الگوریتم است؟
در پروژههای واقعی علم داده، معمولاً:
حدود ۷۰ تا ۹۰ درصد زمان صرف جمعآوری، پاکسازی، اعتبارسنجی و آمادهسازی دادهها میشود.
تنها ۱۰ تا ۳۰ درصد صرف طراحی و آموزش مدل میشود.
به همین دلیل گفته میشود:
«داده، سوخت موتور هوش مصنوعی است.»
۳. داده در بازار شرطبندی چیست؟
داده فقط نتایج مسابقات نیست.
بلکه شامل مجموعهای گسترده از اطلاعات است، از جمله:
نتایج تاریخی
زمان گلها
امید گل (xG)
ترکیب تیمها
مصدومیتها
محرومیتها
وضعیت آبوهوا
ضرایب اولیه و پایانی
حجم معاملات
تغییرات ضرایب
آمار فنی مسابقه
دادههای ردیابی بازیکنان
(Tracking Data)
اطلاعات داوری
تراکم مسابقات
سفرهای تیم
دادههای فیزیولوژیک
اخبار و شبکههای اجتماعی
هر نقص در این زنجیره میتواند کیفیت پیشبینی را کاهش دهد.
۴. ابعاد کیفیت داده
کیفیت داده فقط به «درست بودن» محدود نمیشود.
ابعاد اصلی آن عبارتاند از:
الف) Accuracy (دقت)
آیا داده واقعاً صحیح است؟
مثلاً ثبت اشتباه تعداد شوتها، مدل را منحرف میکند.
ب) Completeness (کامل بودن)
آیا همه دادهها موجودند؟
داده ناقص باعث ایجاد سوگیری میشود.
ج) Consistency (سازگاری)
آیا منابع مختلف با یکدیگر تناقض ندارند؟
د) Timeliness (بهروز بودن)
اطلاعات قدیمی، در بازارهای زنده تقریباً بیارزش هستند.
هـ) Validity (اعتبار)
آیا دادهها مطابق تعریف استاندارد ثبت شدهاند؟
و) Uniqueness (یکتایی)
وجود رکوردهای تکراری میتواند مدل را دچار خطا کند.
۵. اثر داده اشتباه بر مدل
فرض کنید:
در ۱۰٪ مسابقات،
تعداد شوتها اشتباه ثبت شده باشد.
مدل ممکن است:
ضرایب را اشتباه برآورد کند.
وزن ویژگیها را نادرست یاد بگیرد.
رابطههای کاذب کشف کند.
در نهایت:
کل سیستم سوددهی از بین میرود.
۶. نویز (Noise)
یکی از بزرگترین دشمنان مدل:
Noise
است.
نویز یعنی:
اطلاعاتی که سیگنال واقعی نیستند.
مثلاً:
خطای انسانی
داده ناقص
اشتباه اپراتور
سنسور معیوب
باعث افزایش نویز میشوند.
۷. سیگنال در برابر نویز
مدل باید:
Signal
را از
Noise
تشخیص دهد.
اگر نویز زیاد باشد،
حتی بهترین الگوریتم نیز الگوهای اشتباه را یاد میگیرد.
۸. Overfitting
ناشی از داده بیکیفیت
گاهی مدل:
نویز را
بهعنوان واقعیت
یاد میگیرد.
این همان:
Overfitting
است.
مدل روی داده آموزشی عالی عمل میکند،
اما در آینده شکست میخورد.
۹. دادههای جانبدارانه (Biased Data)
فرض کنید:
تمام دادهها فقط مربوط به لیگ برتر انگلیس باشند.
سپس مدل را روی لیگ آرژانتین اجرا کنیم.
احتمالاً عملکرد ضعیفی خواهد داشت.
علت:
Sample Bias
است.
۱۰. دادههای گمشده (Missing Data)
در بسیاری از لیگها:
ایکس جی وجود ندارد.
اطلاعات پزشکی ناقص است.
آمار فنی کامل نیست.
مدل باید:
داده را تخمین بزند،
حذف کند،
یا روش مقاومی انتخاب کند.
هر تصمیم پیامد آماری متفاوتی دارد.
۱۱. برچسبهای اشتباه (Label Errors)
اگر خروجی آموزشی اشتباه باشد،
مدل نیز اشتباه آموزش میبیند.
مثلاً:
اگر نتیجه مسابقهای به اشتباه ثبت شود،
کل فرآیند یادگیری مختل میشود.
۱۲. مفهوم Data Drift
دادهها ثابت نیستند.
سبک فوتبال تغییر میکند.
قوانین تغییر میکنند.
وی ای آر اضافه میشود.
تاکتیکها عوض میشوند.
در نتیجه:
توزیع داده نیز تغییر میکند.
[7/27/2026 8:46 PM] Alfredo: این پدیده:
Data Drift
نام دارد.
۱۳. Concept Drift
گاهی:
رابطه میان متغیرها
تغییر میکند.
مثلاً:
سالها مالکیت توپ اهمیت زیادی داشت.
اما بعدها:
ضدحملات سریع
موفقتر شدند.
در نتیجه:
مدل قدیمی دیگر معتبر نیست.
۱۴. هزینه اقتصادی داده بیکیفیت
فرض کنید:
مدل:
ROI = ۵٪
تولید میکند.
اما:
فقط ۳٪ خطای داده وارد شود.
ممکن است:
ROI
به:
منفی ۲٪
تبدیل شود.
یعنی کیفیت داده مستقیماً سود سرمایه را نابود میکند.
۱۵. داده بهتر یا الگوریتم بهتر؟
یکی از یافتههای مهم صنعت هوش مصنوعی:
بهبود کیفیت داده، معمولاً بیش از تعویض الگوریتم، عملکرد مدل را افزایش میدهد.
به همین دلیل شرکتهای بزرگ سرمایهگذاری قابلتوجهی در زیرساخت داده انجام میدهند.
۱۶. مهندسی ویژگیها
(Feature Engineering)
حتی داده صحیح نیز باید به ویژگیهای مناسب تبدیل شود.
مثلاً:
بهجای:
تعداد گل
ممکن است بهتر باشد:
میانگین گل در پنج بازی اخیر
استفاده شود.
یا:
بهجای مالکیت توپ،
از:
مالکیت در یکسوم هجومی
استفاده شود.
کیفیت Feature Engineering اغلب تعیین میکند که مدل تا چه حد از داده خام ارزش استخراج کند.
۱۷. منابع مختلف داده
در شرطبندی حرفهای معمولاً داده از چندین منبع جمعآوری میشود:
ارائهدهندگان داده رسمی
دادههای اپتیکی و ردیابی
ضرایب بازار
اخبار
دادههای پزشکی
اطلاعات آبوهوا
دادههای شبکههای اجتماعی
ترکیب این منابع، اگر بهدرستی انجام شود، میتواند قدرت پیشبینی را افزایش دهد؛ اما اگر ناسازگار باشند، خود به منبع خطا تبدیل میشوند.
۱۸. اعتبارسنجی داده (Data Validation)
قبل از ورود داده به مدل، باید کنترل شود:
آیا مقدار غیرممکن وجود دارد؟
آیا داده تکراری است؟
آیا زمانها منطقی هستند؟
آیا مقادیر خارج از محدودهاند؟
آیا قالب داده صحیح است؟
این مرحله از ارزانترین و مؤثرترین راههای کاهش خطاست.
۱۹. پاکسازی داده (Data Cleaning)
پاکسازی شامل:
حذف دادههای معیوب
اصلاح قالبها
حذف رکوردهای تکراری
یکسانسازی نام تیمها و بازیکنان
مدیریت دادههای گمشده
است.
در بسیاری از پروژهها، این مرحله بیشترین زمان را میگیرد.
۲۰. همگامسازی زمانی
(Temporal Alignment)
یکی از خطاهای رایج، استفاده از دادهای است که در زمان تصمیمگیری هنوز در دسترس نبوده است.
برای مثال، اگر در آموزش مدل از اطلاعاتی استفاده شود که پس از بسته شدن بازار منتشر شدهاند، سوگیری نگاه به آینده (Look-Ahead Bias) ایجاد میشود و عملکرد مدل بهطور مصنوعی بهتر از واقعیت به نظر میرسد.
۲۱. دادههای بازار بهعنوان منبع اطلاعات
ضرایب اولیه، ضرایب پایانی، حجم معاملات و تغییرات ضریب ، خود نوعی داده هستند.
این دادهها خلاصهای از اطلاعات هزاران معاملهگر را در خود دارند و در بسیاری از مدلهای پیشرفته، بهعنوان یکی از مهمترین ویژگیهای ورودی استفاده میشوند.
۲۲. اقتصاد کیفیت داده
کیفیت داده یک هزینه نیست؛ بلکه یک سرمایهگذاری است.
سندیکاهای بزرگ و شرکتهای تحلیل ورزشی میلیونها دلار صرف موارد زیر میکنند:
خرید داده اختصاصی
ایجاد پایگاههای داده اختصاصی
اعتبارسنجی خودکار
جمعآوری داده بلادرنگ
توسعه استانداردهای داخلی کیفیت
زیرا ارزش اقتصادی یک مدل پیشبینی، مستقیماً به کیفیت دادهای وابسته است که بر پایه آن آموزش دیده است.
۲۳. چرخه عمر داده
در یک سیستم حرفهای، داده از چرخه زیر عبور میکند:
جمعآوری (Collection)
اعتبارسنجی (Validation)
پاکسازی (Cleaning)
یکپارچهسازی (Integration)
مهندسی ویژگی (Feature Engineering)
آموزش مدل (Training)
ارزیابی (Evaluation)
پایش مداوم کیفیت (Monitoring)
ضعف در هر مرحله، میتواند کل چرخه را تضعیف کند.
۲۴. آینده: از «کلانداده» به «داده باکیفیت»
در سالهای نخست هوش مصنوعی، تمرکز بر افزایش حجم داده بود.
اما روند امروز نشان میدهد که مزیت رقابتی واقعی ، در کیفیت، صحت، سرعت و قابلیت اعتماد داده است، نه صرفاً تعداد رکوردها.
به همین دلیل، بسیاری از سازمانهای پیشرو شعار خود را از «Big Data» به «Good Data» تغییر دادهاند.
در بازارهای شرطبندی، کیفیت داده مهمترین عامل موفقیت مدلهای پیشبینی است.
الگوریتمهای پیچیده، شبکههای عصبی عمیق و مدلهای آماری پیشرفته، تنها زمانی ارزشمند هستند که بر پایه دادههای دقیق، کامل، بهروز و سازگار آموزش ببینند.
l: اصل Garbage In, Garbage Out یادآور این واقعیت بنیادین است که هوشمندترین مدلها نیز نمیتوانند خطاهای سیستماتیک داده را جبران کنند. در عمل، تفاوت میان یک مدل سودآور و یک مدل زیانده، اغلب نه در انتخاب الگوریتم، بلکه در کیفیت فرآیند جمعآوری، پاکسازی، اعتبارسنجی و مهندسی داده نهفته است. از این رو، در اقتصاد دیجیتال شرطبندی، «مزیت اطلاعاتی» بیش از آنکه حاصل فرمولهای پیچیده باشد، نتیجه سرمایهگذاری بلندمدت در زیرساخت داده است.